
PLO5・PLO6のエクイティ計算、試行回数はいくつ必要?
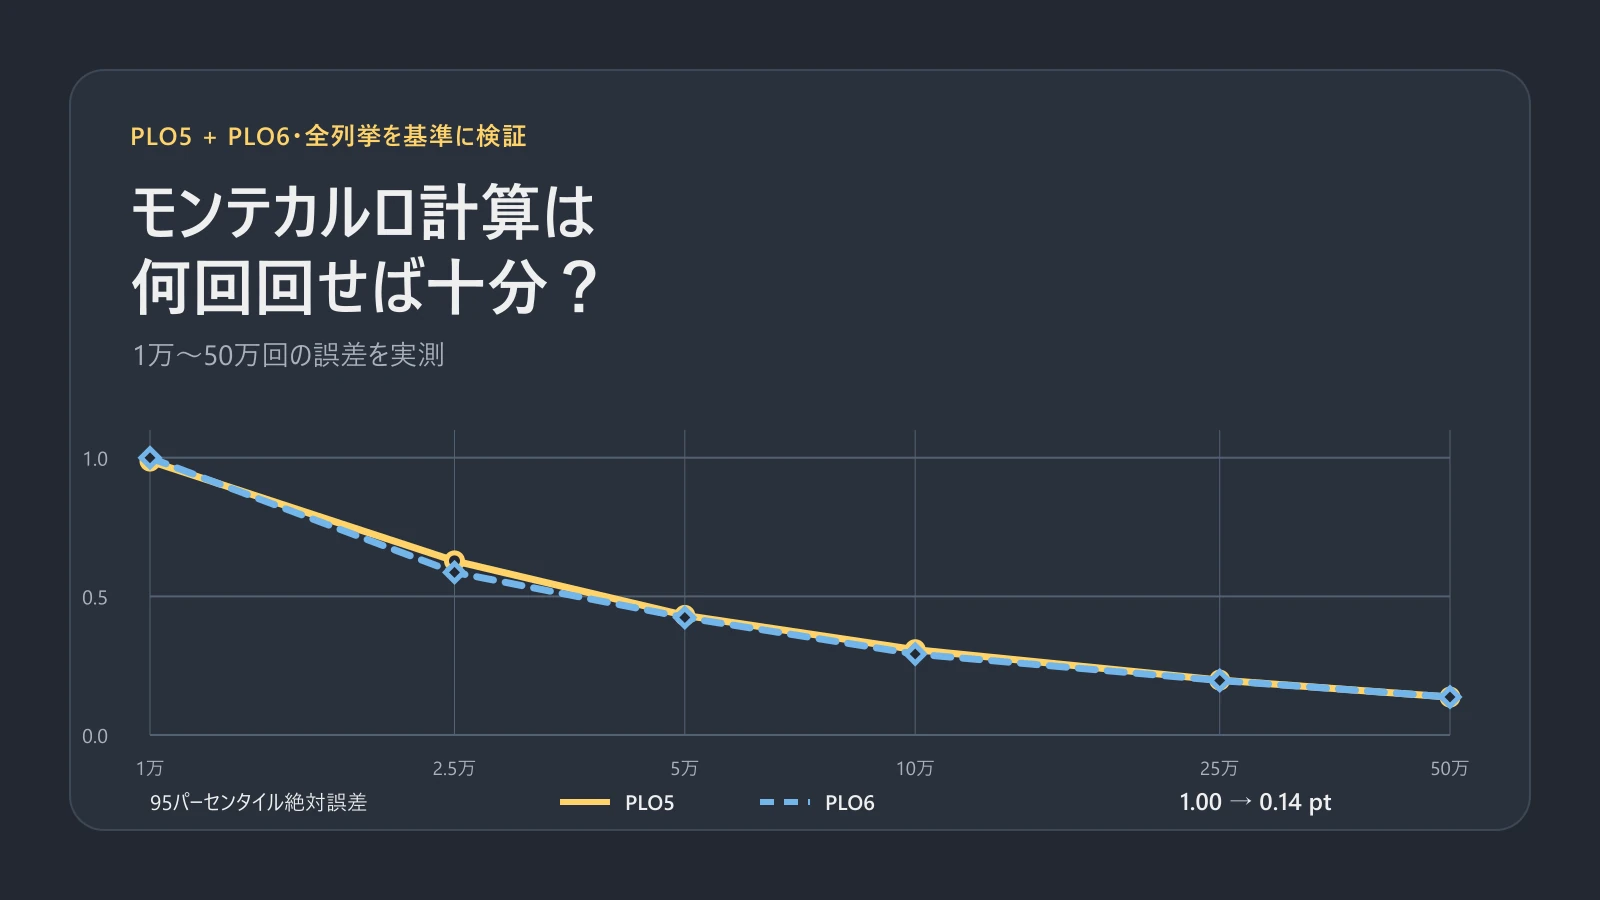
先に結論です。固定ハンド6組を対象にした今回の検証では、1回のモンテカルロ推定と全列挙値の絶対差について、各スポットの95パーセンタイルのうち最大は、試行1万回で約1.00ポイント、5万回で0.43ポイント、10万回で0.31ポイント、50万回で0.14ポイントでした。 PLO5とPLO6は、ほぼ同じ誤差曲線を描きました。
ただし、これは1回の推定値と固定された正確なエクイティとの差です。独立に回した2つの推定値を比べる場合は、両方の標本誤差が差に影響します。この表の数字を「2つの結果がこれ以上離れたら有意」という判定線には使えません。僅差を調べるなら、再計算する、試行回数を増やす、または可能なら全列挙を使います。
基準値は、PLO5の3組とPLO6の3組について、合法な最終ボードをすべて評価して求めました。その後、各スポット・試行回数の組み合わせを固定シードで2,000回ずつ反復し、合計72,000回の推定結果を作りました。ハンド、シード、コード、出力はすべて下からダウンロードできます。
開示:本記事はGTO Geckoが公開しています。後半で触れるOmahaCalcもGTO Solutions ASの製品です。この検証は記事用に別途生成したもので、OmahaCalcや他のアプリの精度・速度を測ったベンチマークではありません。例は検証用に構成した入力であり、実戦ハンドや戦略の推奨ではありません。
この6スポットから試行回数を読むなら
- 1万回:全体像を素早く見るには使えますが、五分に近いスポットでは1ポイント程度の違いも標本の揺れで起こり得ます。
- 5万回:各スポットの95パーセンタイル絶対誤差のうち最大が0.45ポイント未満になりました。
- 10万回:同じ指標は約0.3ポイントでした。
- 50万回:約0.14ポイントまで縮みました。ただし、試行回数は1万回の50倍です。
これは公開した6スポットでの実測値であり、あらゆるレンジ、マルチウェイ、特殊な引き分け構造に対する保証ではありません。
1万回から50万回まで、誤差はどこまで縮んだか
各スポットと試行回数について、モンテカルロ推定値と全列挙値の絶対差を小さい順に並べました。95パーセンタイルは、そのスポットの2,000回の推定のうち、およそ95%がその値以下の誤差だったことを表します。グラフには、PLO5とPLO6それぞれで3スポット中最も大きかった95パーセンタイルを載せています。
狭い画面では表を横にスクロールできます。誤差の単位はパーセントポイントです。
| 試行回数 | PLO5の誤差 | PLO6の誤差 | 1万回との比較 |
|---|---|---|---|
| 10,000 | 0.99ポイント | 1.00ポイント | 基準 |
| 25,000 | 0.63ポイント | 0.59ポイント | 約59〜64% |
| 50,000 | 0.43ポイント | 0.42ポイント | 約42〜43% |
| 100,000 | 0.31ポイント | 0.29ポイント | 約29〜31% |
| 250,000 | 0.20ポイント | 0.20ポイント | 約20% |
| 500,000 | 0.14ポイント | 0.14ポイント | 約14% |
全スポットをまとめた絶対誤差の中央値は、1万回で0.287ポイント、10万回で0.090ポイント、50万回で0.041ポイントでした。中央値より広いスポット別95パーセンタイルを先に示したのは、典型的な1回だけでなく、誤差が大きく出た1回も見落とさないためです。
試行回数をどう選べば、表示値を読み過ぎずに済むか
まず決めるべきなのは、1つの固定ハンド対固定ハンドの推定にどれだけの精度が必要かです。10万回で55.2%と表示されても、この検証セットで誤差が広かったスポットなら、全列挙値から数十分の一ポイント離れている可能性があります。独立した2回の実行が55.2%と55.4%になっても、両方に標本誤差があるため、10万回というだけで0.2ポイント差を判別できたことにはなりません。
- 1万回は方向を見るために使う。今回の検証セットでは、最も誤差が広いスポットでも、個々の推定の約95%が全列挙値からおよそ1ポイント以内でした。
- 1回の推定値をもう少し安定させるなら5万〜10万回。95パーセンタイル絶対誤差の最大は、5万回で0.42〜0.43ポイント、10万回で0.29〜0.31ポイントでした。
- 数十分の一ポイントが重要なら25万〜50万回。1回の推定値の誤差は約0.20、0.14ポイントまで縮みましたが、ゼロにはなりません。2つの標本値を比べるときは、引き続き両方の不確実性を考えます。
- 固定ハンドの状態空間を現実的に全列挙できるなら、そちらを優先する。すべて数えられる状態を、さらに標本抽出して近似する必要はありません。
これを万能のプリセットにはしないでください。相手レンジ、デッドカード、3人以上、ダブルボードなどを標本化する計算機ではモデルが異なります。また、生のエクイティと期待値は別物です。ショーダウンエクイティの小数点を安定させても、ポジション、スタック、以後のベット、フォールド、レーキ、エクイティ実現率は追加されません。この違いはポーカーのエクイティ解説で整理しています。
試行回数を4倍にしても、誤差は約半分にしかならない
モンテカルロのエクイティ推定は平均値です。勝ちを1、引き分けを0.5、負けを0とすると、その平均が推定エクイティになります。標本平均の標準誤差は、試行回数をNとして、おおむね1 / √Nに比例して小さくなります。NISTの平均値に関する信頼限界にも同じ平方根の項があります。
つまり、誤差を半分にするには試行回数をおよそ4倍にする必要があります。1万回から10万回への変更は試行回数を10倍にしますが、期待される誤差の尺度は1/√10、つまり約3.16分の1です。今回の最も広いスポットも、約1.00ポイントから約0.30ポイントへ縮み、ほぼ同じ形になりました。
近似95%信頼区間についても校正を確認しました。各試行回数で6スポット、合計12,000回の推定をまとめると、全列挙値を区間内に含んだ割合は約95.0〜95.5%でした。これは、計算済みの1本の区間に正解が入る確率が95%という意味ではありません。同じ方法で標本抽出を繰り返したとき、固定された正解をおよそ95%の区間が含む、という手続きの性質です。詳しくはNISTの信頼区間の説明を参照してください。
PLO5・PLO6の正確な基準値を全列挙で作る
PokerStarsのOmahaルールでは、最終的な5枚役にホールカードを正確に2枚、コミュニティカードを正確に3枚使います。5カードPLOと6カードOmahaでも、ホールカードが5枚または6枚に増えるだけで、この2枚+3枚の構成は同じです。本検証は、標準52枚デッキのPLO5・PLO6ハイに限定しました。
- PLO5:既知の5枚ハンドが2人分あるため10枚を除き、残り42枚から最終ボード5枚を選びます。C(42, 5) = 850,668通りです。
- PLO6:既知の6枚ハンドが2人分あるため12枚を除き、残り40枚から選びます。C(40, 5) = 658,008通りです。
PLO6のボード数が少ないのは、既知のホールカードが多いからです。一方、各プレイヤーが評価するホールカード2枚の組み合わせは、PLO5の10通りに対してPLO6は15通りです。本検証では処理時間を測っていないため、このボード数から特定のツールでどちらが速いかは判断できません。
どの最終ボードにも並べ方が120通りあり、すべて同数なので、順序を除いた各ボードを同じ重みで数えられます。各ボードで両者の合法なOmaha役を比較し、勝ち、引き分け、負けを数え、引き分けには0.5を与えました。これは標本抽出ではなく完全な全列挙です。別方式で実装した検算器でも、6スポットすべての正確な合計が一致しました。
| スポット | Hero | Villain | 勝ち / 引き分け / 負け | 正確なエクイティ |
|---|---|---|---|---|
| P5-A | A♠ A♥ K♠ K♥ Q♣ | J♣ T♣ 9♦ 8♦ 7♥ | 469,214 / 66 / 381,388 | 55.1622% |
| P5-B | A♠ K♠ Q♥ J♥ T♣ | A♦ K♦ Q♣ J♣ 9♠ | 294,553 / 298,784 / 257,331 | 52.1878% |
| P5-D | A♠ A♥ K♠ K♥ Q♣ | 2♣ 2♦ 2♥ 3♠ 4♠ | 669,638 / 0 / 181,030 | 78.7191% |
| P6-A | A♠ A♥ K♠ K♥ Q♣ J♣ | T♣ 9♣ 8♦ 7♦ 6♥ 5♥ | 359,603 / 0 / 298,405 | 54.6502% |
| P6-B | A♠ K♠ Q♠ J♥ T♥ 9♦ | A♦ K♦ Q♦ J♣ T♣ 8♣ | 225,107 / 255,322 / 177,579 | 53.6115% |
| P6-D | A♠ A♥ K♠ K♥ Q♣ J♣ | 2♣ 2♦ 2♥ 2♠ 3♦ 4♦ | 533,331 / 0 / 124,677 | 81.0524% |
A、B、Dは順番ではなく役割を表すラベルです。Aは誤差が最も広かった五分に近いケース、Bは引き分けを意図的に多くしたケース、Dは低い同ランクカードを集めた意図的に偏りの大きい合成ストレステストです。結果の分散が異なるスポットを並べていますが、PLO全体から無作為に選んだ標本ではなく、スターティングハンドの順位表でもありません。ハンド選択は別記事のPLOスターティングハンドガイドで扱っています。
精度を左右したのは、PLO5かPLO6かより引き分けの多さ
誤差が最も広かったのはP5-AとP6-Aです。どちらもエクイティが50〜55%付近で、ほとんど引き分けません。1万回での95パーセンタイル絶対誤差は、それぞれ0.99ポイントと1.00ポイントでした。一方、引き分けの多いP5-BとP6-Bは0.76ポイントと0.75ポイントでした。
引き分けは毎回0.5を与え、0と1のちょうど中間に固定されます。平均値が同程度なら、0と1の間を大きく行き来する結果より、引き分けを多く含む結果のほうが分散は小さくなります。結果の分散が小さければ、同じ試行回数でも標本平均の分布が狭くなります。偏りの大きいDスポットがAスポットより速く収束したのも同じ理由です。
したがって、今回のPLO5とPLO6の曲線はほぼ重なりました。ホールカードの枚数だけで、モンテカルロ推定の標本誤差が決まるわけではありません。固定したシナリオでは、勝ち・引き分け・負けの分布と、独立した試行の数が効きます。PLO6は1ボードを評価する計算が増える可能性がありますが、実行時間は本検証の対象外です。
今回シミュレートしたもの、していないもの
全列挙の後、各モンテカルロ反復では、そのスポットで得られた正確な勝ち・引き分け・負けの分布から結果を標本抽出しました。これは、1回の試行内では重複しない5枚を合法な最終ボードとして一様に配り、次の試行前にボードを戻し、Heroが勝ったか、引き分けたか、負けたかだけを残す方法と統計的に等価です。試行間では復元抽出になります。
乱数生成にはNumPy 2.2.3のPCG64を使い、スポットと設定ごとの決定論的シードを公開しています。別のカード単位チェックでは、各スポットについて実際の合法な最終ボードを25,000回ずつ無作為抽出して評価し、6組すべての推定値が全列挙値から1.41標準誤差以内に収まりました。1回の実行内で同じボードを二度引かない非復元抽出なら、有限個の全ボードに近づくほど誤差はさらに狭くなるため、この誤差表をその設計へそのまま移してはいけません。
本検証は、次のものを測っていません。
- 未知のハンド、相手レンジ、レンジの重み付け
- マルチウェイ、ダブルボード、デッドカード、Omaha Hi-Lo
- 端末速度、アプリ出力、特定実装の性能
- ポジション、ベット、フォールドエクイティ、レーキ、エクイティ実現率、意思決定EV
- 公開した6スポットを超える普遍的な最大誤差
未知のカードが1枚か2枚だけなら、全列挙のほうが小さく済む場合があります。たとえばPLOラップの検証では、固定フロップからのターン・リバー820通りをすべて評価しています。完全な状態空間が大き過ぎる場合や、レンジと複数プレイヤーをモデルへ入れる場合に、モンテカルロ法の利点が大きくなります。
OmahaCalcとの関係
OmahaCalcで以前の計算設定を開き直す場合は、英語版のRECENT設定チェックリストを使い、復元された入力、現在の試行回数設定、新しく計算した結果を分けて記録できます。
2026年9月21日に確認した日本向けApp StoreのOmahaCalc掲載情報では、PLO5・PLO6のモンテカルロエクイティ計算、既知ハンドとボードカード、複数プレイヤー、ハンドランキングの閲覧、パーセンタイルフィルター、レンジ分析が説明されています。確認時のバージョンは1.1.8です。掲載情報は機能の存在の根拠としてのみ使い、日本語表示の範囲やアプリ固有の精度・速度は本記事では検証していません。
本検証のハンドをOmahaCalcへ入力して出力を照合したわけではなく、アプリの内部実装や処理速度も測っていません。どのモンテカルロ計算機を使う場合でも、モデル、試行回数、結果を一緒に記録し、結論では表示桁を読み過ぎないことが重要です。気にしている差が今回の誤差尺度に近いなら、同じ条件で再計算するか、試行回数を増やします。計算ツールは卓外の学習に使い、プレイするゲームやプラットフォームの規則に従ってください。
データをダウンロードして再現する
主実装は、5枚役の順位付けにオープンソースのPH Evaluatorを使います。別方式で実装した検算器は、純Pythonのランクタプルと辞書型のボード評価器を使います。5枚の組み合わせ2,598,960通り、異なる役順位7,462クラス、6スポットの全ボードを検査し、スート同型、プレイヤー入れ替え、ボード順、重複カード、A-5ストレート、フルハウス、キッカーも確認しました。
- 日本語の再現手順とファイル案内
- ハンド、勝ち・引き分け・負け、正確なエクイティ(CSV)
- スポット別・形式別・全体の誤差要約(CSV)
- 72,000行の全反復結果(圧縮CSV)
- 入力、シード、結果、チェックサム、制約(JSON)
- 主生成器(Python)と別実装の検算器(Python)
- 固定したPython依存関係と検算レポート
- 公開ファイルのSHA-256マニフェスト
2本のスクリプト、依存関係ファイル、正確なマッチアップCSVを同じフォルダーへ保存してください。固定した依存関係をインストールして生成器と検算器を実行すると、どちらもplo-monte-carlo-outputへ再生成ファイルを書き出します。6スポットをすべて全列挙するため、完了まで数分かかる場合があります。
PLOモンテカルロ精度のよくある質問
- PLOエクイティ計算は1万回で十分ですか?
- 今回の検証セットでは、方向を見るための概算には使えました。最も誤差が広いスポットでも、95パーセンタイル絶対誤差は約1ポイントです。ただし、数十分の一ポイント差を安定して判別するには足りません。必要な精度と計算モデルから決めるべきで、万能の回数はありません。
- 同じハンドなのに、再計算するとエクイティが変わるのはなぜですか?
- モンテカルロ法は合法な結果をランダムに標本抽出します。標本ごとに勝ち、引き分け、負けの割合が少し変わるため、その平均も固定された正確なエクイティの周囲で動きます。試行回数を増やすと動きは狭くなりますが、1回の標本値が全列挙値になるわけではありません。
- PLO6はPLO5より多くの試行回数が必要ですか?
- 自動的にそうなるわけではありません。今回の固定ハンド6組では、PLO5とPLO6の誤差曲線はほぼ同じでした。標本精度を決めたのは結果の分散と試行回数です。PLO6は各ハンド内で評価する2枚組が多く、処理時間へ影響する可能性がありますが、本検証では速度を測っていません。
- 全列挙は常にモンテカルロ法より優れていますか?
- 正しいモデルの状態空間を現実的な時間で全列挙できるなら、決定論的な答えを得られる利点があります。相手レンジ、プレイヤー数、未知カードが増えて全列挙が高価になると、モンテカルロ法が有用になります。ただし、間違ったレンジ仮定を正確に計算しても、モデル自体は正しくなりません。
- エクイティの精度を上げれば、正しいアクションも分かりますか?
- いいえ。本実験が測るのは固定ハンド同士のショーダウンエクイティです。意思決定にはレンジ、ポットオッズ、ポジション、スタック、今後のアクション、フォールド、場合によってはレーキやトーナメント賞金も関わります。1つの入力が精密でも、戦略全体にはなりません。
出典と手法資料
- Apple App Store:OmahaCalc — 現在の製品情報とバージョン。2026年9月21日確認。
- PokerStars:Omahaルール、5カードPLO、6カードOmaha — 2枚+3枚の役構成。2026年9月21日確認。
- NIST/SEMATECH:平均値の信頼限界、信頼区間の解釈 — 2026年9月21日確認。
- NumPy 2.2:PCG64、多項分布標本抽出 — 2026年9月21日確認。公開バンドルはNumPy 2.2.3を固定。
- PH Evaluatorソース — 2026年9月21日確認。公開バンドルはphevaluator 0.6.0を固定。